学习模型预测控制(MPC)时,我主要关注模型、代价和约束如何组成一个滚动求解的问题。这篇笔记重点整理凸 MPC,以及它与一次性轨迹优化和 LQR 的区别。
先修知识: LQR、线性系统离散化、凸二次规划与基本的稀疏矩阵运算。
阅读路线:
- 用航天器交会案例对照 LQR、凸轨迹优化和凸 MPC。
- 通过平面无人机悬停,连接非线性模型、局部线性化与离散模型。
- 推导堆叠预测矩阵,再把代价和约束整理为 OSQP 所需的形式。
笔记结合 CMU 16-745 的课程与作业整理,相关材料见课程作业页面。文中的代码片段保留学习时的实现,运行时还需使用对应作业的依赖与上下文。
Lecture 10:凸模型预测控制
LQR(线性二次调节器)是控制理论中的经典方法,但存在一些局限
- 仅适用于线性系统和局部线性化的非线性系统
- 代价函数需要是二次型
- 无法直接处理控制输入约束或状态约束
MPC通过滚动优化克服LQR的局限性,在每一个时间步求解一个有限时域的优化问题,考虑未来若干步的动力学和约束,并仅应用优化结果的第一步控制输入,下一时间步重新优化,具有以下优势
- 显式处理约束:将控制限幅、状态约束直接写入优化问题
- 可扩展性:MPC 框架可用于非线性问题,但非线性 MPC 通常不再是凸问题。本文的凸 MPC 依赖线性/仿射动力学、凸代价和凸约束,不能直接套用到任意非线性模型。
- 适应性:可实时响应环境变化(如障碍物移动)
HW2_Q3 Optimal Rendezvous and Docking航天器交汇
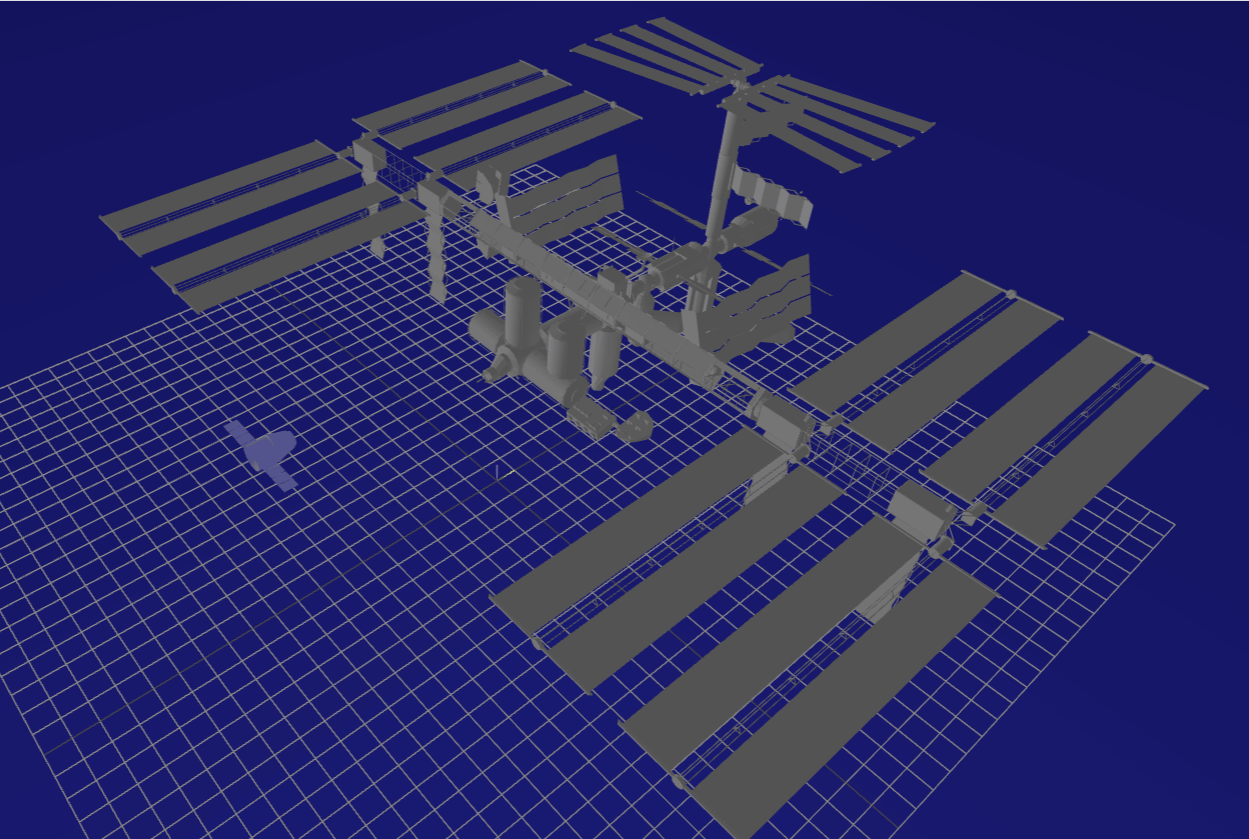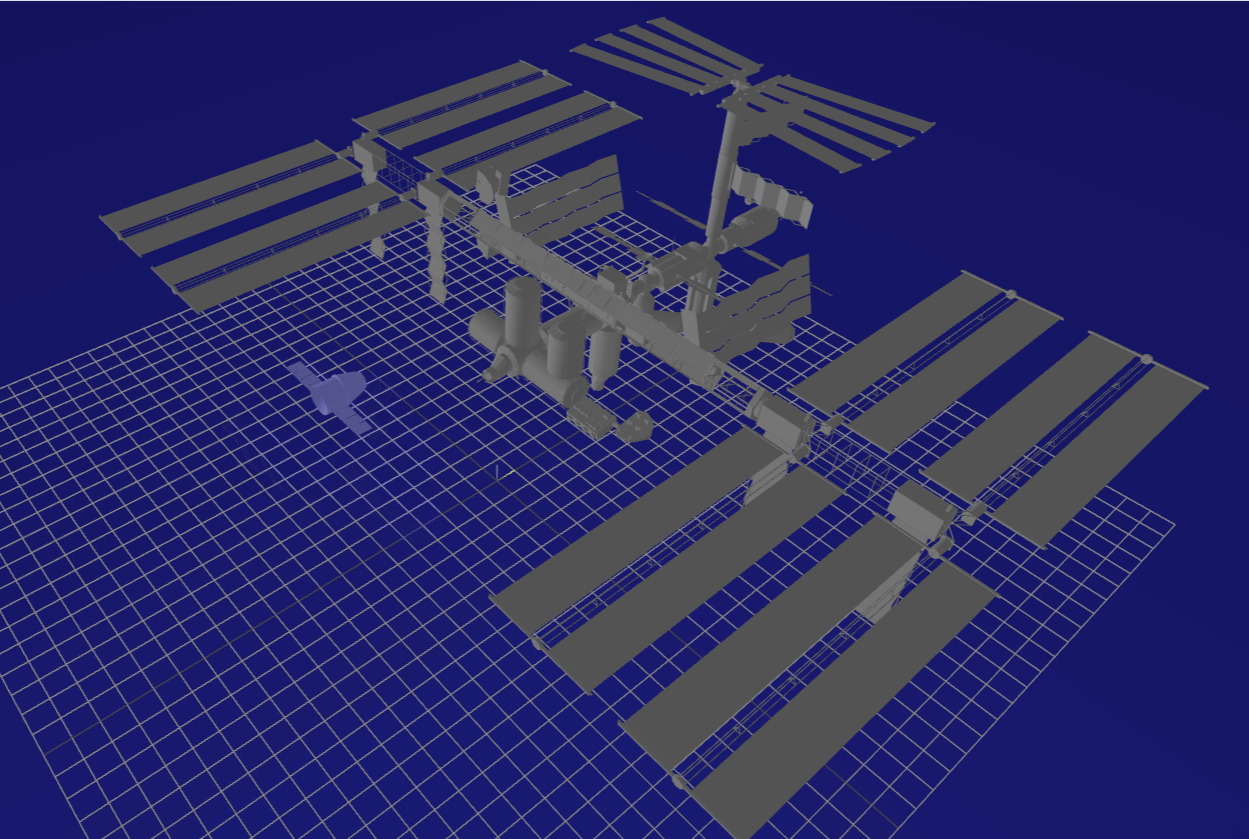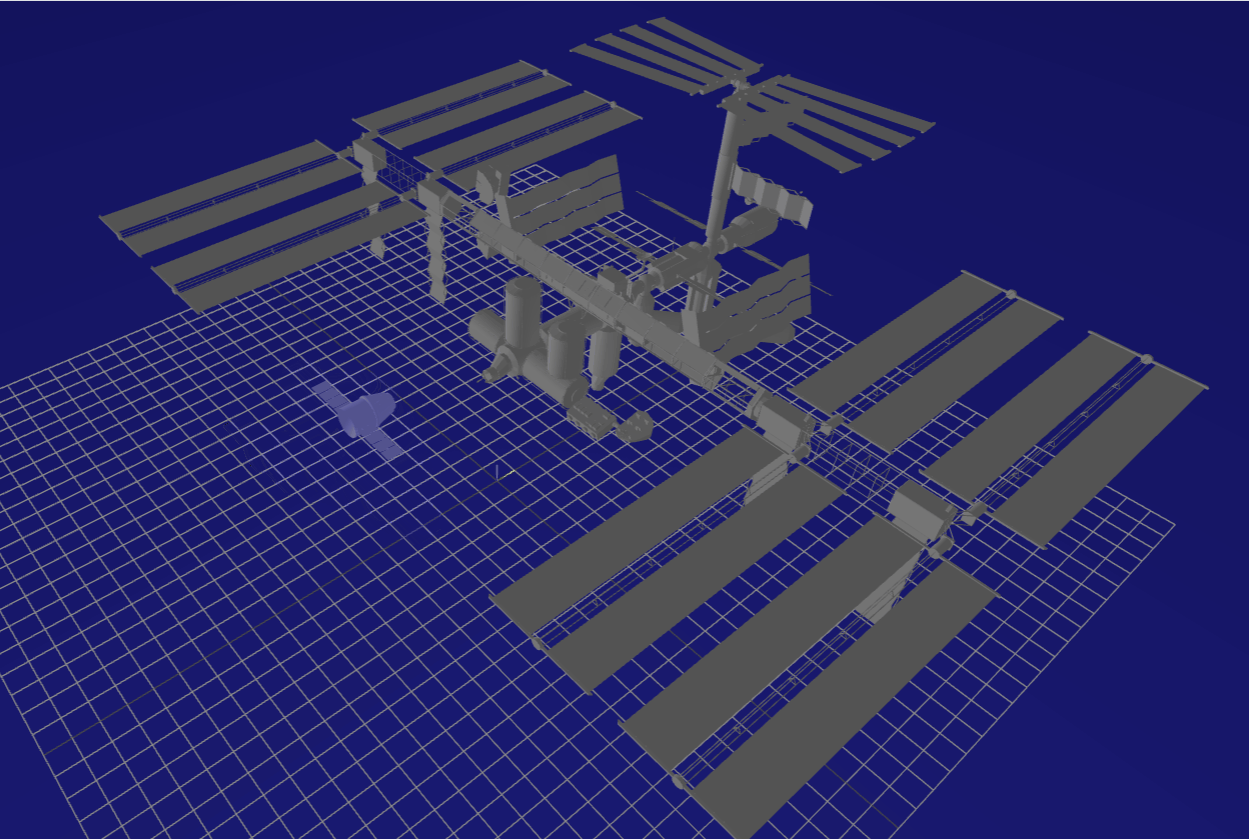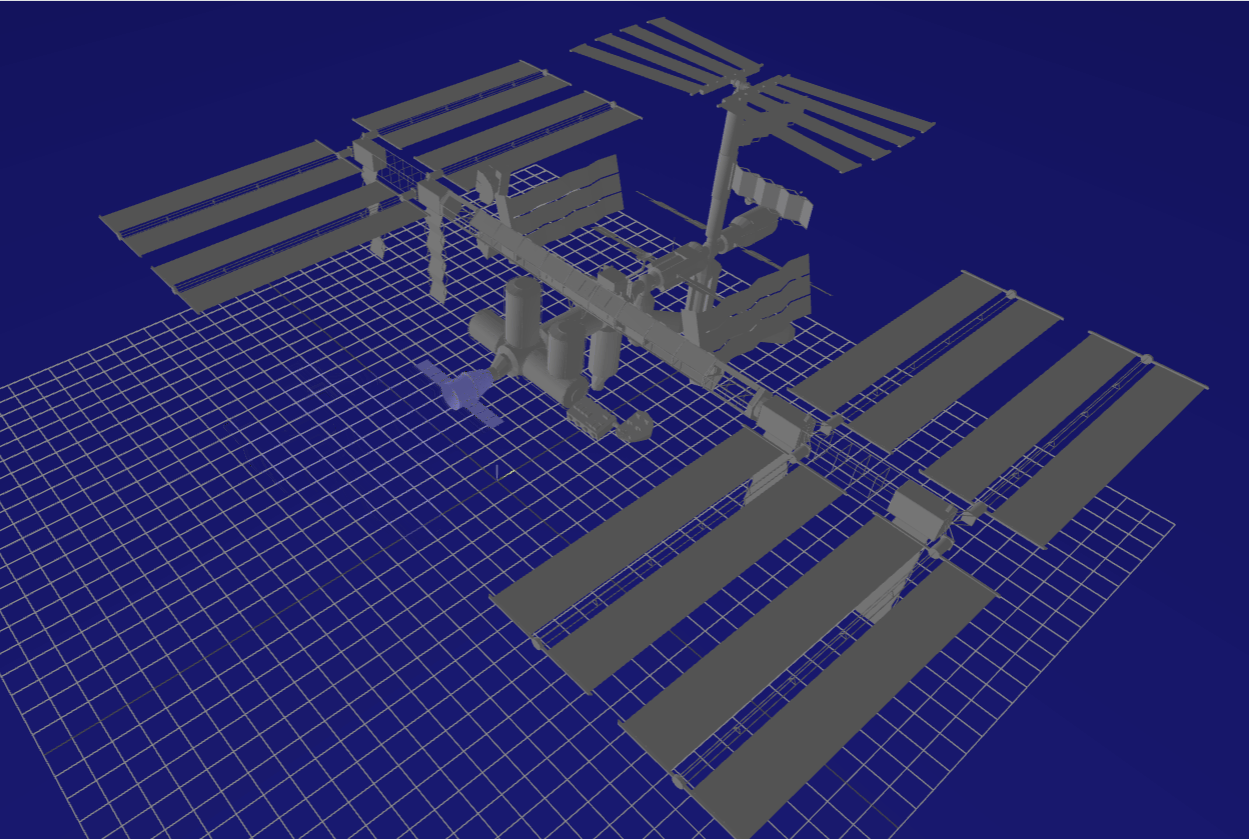
接下来将针对SpaceX Dragon飞船与国际空间站(ISS)的交会对接,使用LQR、凸轨迹优化、凸MPC三种控制方法
状态变量为的位置和速度,控制变量为飞船三轴推力
系统的连续时间动力学模型如下(Clohessy-Wiltshire 方程)
- 矩阵包含轨道动力学效应(科里奥利力、离心力)
- 为轨道平均角速度。下方代码采用 、;复现时统一按代码参数,不混用其他轨道半径。
- 上式输入矩阵为单位加速度输入形式;若 表示推力,应乘相应的质量倒数。下方代码使用
0.1*I(3),复现时须核对这一输入缩放与单位。
Part A: Discretize the dynamics系统离散化
使用增广矩阵进行系统离散化
function create_dynamics(dt::Real)::Tuple{Matrix,Matrix} mu = 3.986004418e14 # standard gravitational parameter a = 6971100.0 # semi-major axis of ISS n = sqrt(mu/a^3) # mean motion
# continuous time dynamics ẋ = Ax + Bu A = [0 0 0 1 0 0; 0 0 0 0 1 0; 0 0 0 0 0 1; 3*n^2 0 0 0 2*n 0; 0 0 0 -2*n 0 0; 0 0 -n^2 0 0 0]
B = Matrix([zeros(3,3);0.1*I(3)])
# TODO: convert to discrete time X_{k+1} = Ad*x_k + Bd*u_k nx,nu =size(B) M = exp([A B; zeros(3,6) zeros(3,3)] * dt) # 增广矩阵 Ad = M[1:nx, 1:nx] Bd = M[1:nx, nx+1:nx+nu] return Ad, BdendPart B
使用有限时域 LQR跟踪给定的参考轨迹
下方实现使用 并进行限幅。它是围绕参考状态的反馈实验;对一般参考轨迹,仅计算调节器增益并减去参考状态,不足以求解上面完整的跟踪最优化问题,还需要参考输入/仿射前馈项及轨迹可行性处理。限幅也会改变无约束 LQR 的最优性与稳定性结论。
# TODO: FHLQRfunction fhlqr(A::Matrix, # A matrix B::Matrix, # B matrix Q::Matrix, # cost weight R::Matrix, # cost weight Qf::Matrix,# term cost weight N::Int64 # horizon size )::Tuple{Vector{Matrix{Float64}}, Vector{Matrix{Float64}}} # return two matrices
# check sizes of everything nx,nu = size(B) @assert size(A) == (nx, nx) @assert size(Q) == (nx, nx) @assert size(R) == (nu, nu) @assert size(Qf) == (nx, nx)
# instantiate S and K P = [zeros(nx,nx) for i = 1:N] K = [zeros(nu,nx) for i = 1:N-1]
# initialize S[N] with Qf P[N] = deepcopy(Qf)
# Ricatti for n in N-1:-1:1 # TODO K[n] = (R+B'*P[n+1]B)\B'*P[n+1]*A P[n] = Q + A'*P[n+1]*(A-B*K[n]) end
return P, Kend
# Solve LQR_, K = fhlqr(A,B,Q,R,Qf,N)
# simulationX_sim = [zeros(nx) for i = 1:N]U_sim = [zeros(nu) for i = 1:N-1]X_sim[1] = x0for i = 1:(N-1) # TODO: put LQR control law here # make sure to clamp U_sim[i] = clamp.(-K[i]*(X_sim[i]-X_ref[i]),u_min,u_max)
# simulate 1 step X_sim[i+1] = A*X_sim[i] + B*U_sim[i]end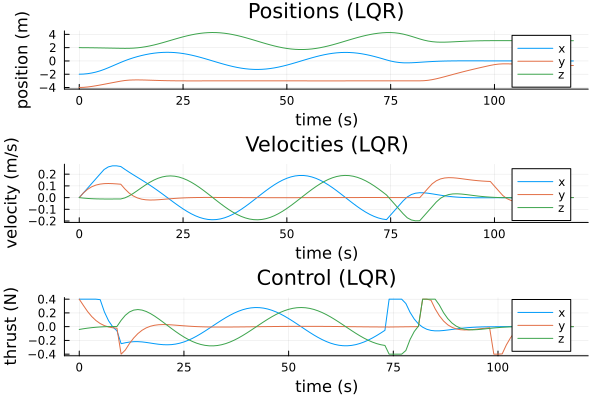
Part C: Convex Trajectory Optimization
"""Xcvx,Ucvx = convex_trajopt(A,B,X_ref,x0,xg,u_min,u_max,N)
setup and solve the above optimization problem, returningthe solutions X and U, after first converting them tovectors of vectors with vec_from_mat(X.value)"""function convex_trajopt(A::Matrix, # discrete dynamics A B::Matrix, # discrete dynamics B X_ref::Vector{Vector{Float64}}, # reference trajectory x0::Vector, # initial condition xg::Vector, # goal state u_min::Vector, # lower bound on u u_max::Vector, # upper bound on u N::Int64, # length of trajectory )::Tuple{Vector{Vector{Float64}}, Vector{Vector{Float64}}} # return Xcvx,Ucvx
# get our sizes for state and control nx,nu = size(B)
@assert size(A) == (nx, nx) @assert length(x0) == nx @assert length(xg) == nx
# LQR cost Q = diagm(ones(nx)) R = diagm(ones(nu))
# variables we are solving for X = cvx.Variable(nx,N) U = cvx.Variable(nu,N-1)
# TODO: implement cost obj = 0 for k =1:N-1 x_k,u_k = X[:,k]-X_ref[k],U[:,k] obj += 0.5*cvx.quadform(x_k,Q)+0.5*cvx.quadform(u_k,R) end
# create problem with objective prob = cvx.minimize(obj)
# TODO: add constraints with prob.constraints = vcat(prob.constraints, ...) prob.constraints = vcat(prob.constraints,(X[:,1]==x0)) prob.constraints = vcat(prob.constraints,(X[:,end]==xg)) for i =1:N-1 #dynamics constraints prob.constraints = vcat(prob.constraints,(X[:,i+1]==A*X[:,i]+B*U[:,i])) # control constraint prob.constraints = vcat(prob.constraints,(U[:,i]<=u_max)) prob.constraints = vcat(prob.constraints,(U[:,i]>=u_min)) end
for i = 1:N prob.constraints = vcat(prob.constraints,(X[2,i]<=xg[2])) end cvx.solve!(prob, ECOS.Optimizer; silent = true)
X = X.value U = U.value
Xcvx = vec_from_mat(X) Ucvx = vec_from_mat(U)
return Xcvx, Ucvxend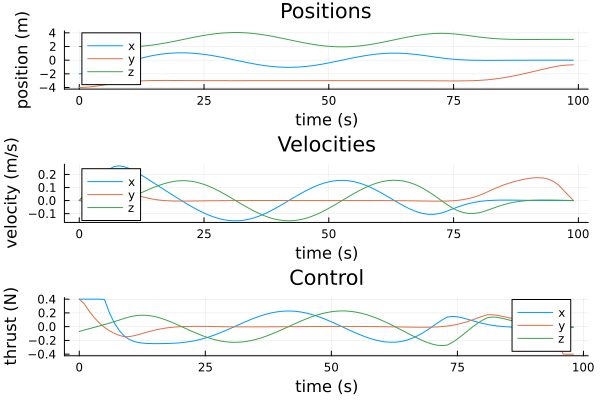
Part D: Convex MPC
在航天器交会对接任务中,(Part C)开环控制无法处理系统中的不确定性,MPC通过滚动时域优化使用反馈控制,弥补“sim-to-real gap”
给定当前时刻的参考轨迹窗口,MPC将求解以下的凸优化问题
参数说明:
- :状态、控制输入和终端状态的权重矩阵
- :预测时域长度
- :当前状态估计(来自传感器滤波)
"""`u = convex_mpc(A,B,X_ref_window,xic,xg,u_min,u_max,N_mpc)`
setup and solve the above optimization problem, returning thefirst control u_1 from the solution (should be a length nuVector{Float64})."""function convex_mpc(A::Matrix, # discrete dynamics matrix A B::Matrix, # discrete dynamics matrix B X_ref_window::Vector{Vector{Float64}}, # reference trajectory for this window xic::Vector, # current state x xg::Vector, # goal state u_min::Vector, # lower bound on u u_max::Vector, # upper bound on u N_mpc::Int64, # length of MPC window (horizon) )::Vector{Float64} # return the first control command of the solved policy
# get our sizes for state and control nx,nu = size(B)
# check sizes @assert size(A) == (nx, nx) @assert length(xic) == nx @assert length(xg) == nx @assert length(X_ref_window) == N_mpc
# LQR cost Q = diagm(ones(nx)) R = diagm(ones(nu)) Qf = 10*Q
# variables we are solving for X = cvx.Variable(nx,N_mpc) U = cvx.Variable(nu,N_mpc-1)
# TODO: implement cost function obj = cvx.quadform(X[:,N_mpc]-X_ref_window[N_mpc],Qf) for i = 1:N_mpc-1 obj +=cvx.quadform(X[:,i]-X_ref_window[i],Q)+cvx.quadform(U[:,i],R) end # create problem with objective prob = cvx.minimize(obj)
# TODO: add constraints with prob.constraints = vcat(prob.constraints, ...) prob.constraints = vcat(prob.constraints,(X[:,1]==xic)) for i =1:N_mpc-1 #dynamics constraints prob.constraints = vcat(prob.constraints,(X[:,i+1]==A*X[:,i]+B*U[:,i])) # control constraint prob.constraints = vcat(prob.constraints,(U[:,i]<=u_max)) prob.constraints = vcat(prob.constraints,(U[:,i]>=u_min)) end
for i = 1:N_mpc prob.constraints = vcat(prob.constraints,(X[2,i]<=xg[2])) end
# solve problem cvx.solve!(prob, ECOS.Optimizer; silent = true)
# get X and U solutions X = X.value U = U.value
# return first control U return U[:,1]end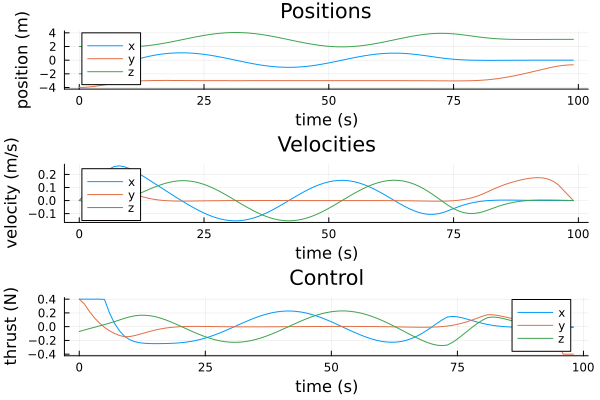
无人机悬停案例
- 平面无人机动力学
为与下方实现一致,这里令 表示两电机间距,因此每侧推力到质心的力臂为 。
在平衡点线性化写成矩阵形式
using LinearAlgebrausing ForwardDiffusing OSQP#Model parametersg = 9.81 #m/s^2m = 1.0 #kgℓ = 0.3 #metersJ = 0.2*m*ℓ*ℓ
h = 0.05 #time step (20 Hz)
#Planar Quadrotor Dynamicsfunction quad_dynamics(x,u) θ = x[3] ẍ = (1/m)*(u[1] + u[2])*sin(θ) ÿ = (1/m)*(u[1] + u[2])*cos(θ) - g θ̈ = (1/J)*(ℓ/2)*(u[2] - u[1]) return [x[4:6]; ẍ; ÿ; θ̈]endfunction quad_dynamics_rk4(x,u) #RK4 integration with zero-order hold on u f1 = quad_dynamics(x, u) f2 = quad_dynamics(x + 0.5*h*f1, u) f3 = quad_dynamics(x + 0.5*h*f2, u) f4 = quad_dynamics(x + h*f3, u) return x + (h/6.0)*(f1 + 2*f2 + 2*f3 + f4)end
#Linearized dynamics for hoveringx_hover = zeros(6)u_hover = [0.5*m*g; 0.5*m*g]A = ForwardDiff.jacobian(x->quad_dynamics_rk4(x,u_hover),x_hover);B = ForwardDiff.jacobian(u->quad_dynamics_rk4(x_hover,u),u_hover);quad_dynamics_rk4(x_hover, u_hover)MPC
离散时不变系统的状态空间方程
定义预测时域为 ,状态维度为 ,输入维度为 。堆叠变量为
逐步代入动力学,可以得到
因此 ,其中
对于零参考状态的调节问题,选取
令 、,则
常数项只与当前状态有关,不影响最优输入。此前笔记的最后一步输入索引和 最后一行次序有误,已按上述递推统一。跟踪非零参考时,还需把参考轨迹引入代价中的线性项。
OSQP 求解器的使用
OSQP 求解器是一个用于求解凸二次规划(形式如下)的数值优化软件包
其中 是优化变量, 是对称半正定矩阵。
考虑一个线性时不变动力学系统到某个参考状的问题
1.给出系统的
Nx = 6 # number of stateNu = 2 # number of controlsTfinal = 10.0 # final timeNt = Int(Tfinal/h)+1 # number of time stepsthist = Array(range(0,h*(Nt-1), step=h));
# Cost weightsQ = Array(1.0*I(Nx));R = Array(.01*I(Nu));Qn = Array(1.0*I(Nx));
#Thrust limitsumin = [0.2*m*g; 0.2*m*g]umax = [0.6*m*g; 0.6*m*g]- 转换成标准 QP 问题
优化变量
对于这里不含 的代价,OSQP 应取 、;跟踪代价的线性项是负号。以下悬停示例改用含 的误差代价,参考是平衡点,变量依次为 ,因此 H=W、b=0。此示例只添加推力限制,未添加上面通式的状态限制。
原代码的 rob/prob 名称不一致,且缺少 Nh、终端权重定义和非零初态右端项;已改为明确分块组装。依赖前面的离散模型和参数;尚未在锁定的 OSQP.jl 环境中运行,下面提供建模示例而非经过仿真验证的控制器。
using SparseArraysNh = 20nb = Nu + Nxuidx(k) = ((k-1)*nb+1):((k-1)*nb+Nu)xidx(k) = ((k-1)*nb+Nu+1):(k*nb)H = spzeros(Nh*nb, Nh*nb)C = spzeros(Nh*Nx, Nh*nb)S = spzeros(Nh*Nu, Nh*nb) # 提取输入for k in 1:Nh rows = ((k-1)*Nx+1):(k*Nx) H[uidx(k), uidx(k)] = R H[xidx(k), xidx(k)] = k == Nh ? Qn : Q C[rows, uidx(k)] = B C[rows, xidx(k)] = -Matrix{Float64}(I, Nx, Nx) if k > 1 C[rows, xidx(k-1)] = A end S[((k-1)*Nu+1):(k*Nu), uidx(k)] = Matrix{Float64}(I, Nu, Nu)endb = zeros(Nh*nb)D = [C; S]rhs = zeros(Nh*Nx)lb = [rhs; repeat(umin-u_hover, Nh)]ub = [rhs; repeat(umax-u_hover, Nh)]prob = OSQP.Model()OSQP.setup!(prob; P=H, q=b, A=D, l=lb, u=ub, verbose=false)
function hover_control(x_now) # B*δu₀ - δx₁ = -A*δx₀,初态必须进入每次优化。 rhs[1:Nx] = -A*(x_now-x_hover) lb[1:Nh*Nx] = rhs ub[1:Nh*Nx] = rhs OSQP.update!(prob; l=lb, u=ub) result = OSQP.solve!(prob) # 演示采用严格成功判据;失败时交由调用方处理,不能盲用 result.x。 result.info.status == :Solved || error("QP 未成功求解:$(result.info.status)") return u_hover + result.x[uidx(1)]end接口和求解状态见 OSQP 的 Julia 文档与所安装的 OSQP.jl 版本。真正的 MPC 仿真还需每步调用控制器、用真实模型推进,并记录约束残差、闭环状态与求解耗时;求解成功不等于非线性系统一定稳定。
整理与核查说明
本笔记原有许可为 CC BY 4.0。引用的课程材料、代码和图片仍须遵守其各自的许可。
核查状态:部分验证(2026-10-04)。 Julia 1.10.10 验证 MPC 分块尺寸、初态残差及 Hessian;未执行完整 OSQP 和航天器实验。
2026-10-04 整理时修正了已定位的公式和实现问题。文中的图片、动画和输出保留自学习时的实验记录,不代表修订后的代码已经完整重跑。作业片段依赖原项目环境,不能直接作为完整可运行教程;具体核查范围与尚未复现事项见正文。
分享文章
生成精美分享图或复制链接,与更多人分享本文。
继续阅读
最后更新于 ,距今已过 0 天
部分内容可能已过时