学习线性二次型调节器(LQR)时,我把二次规划和 Riccati 递推放在一起整理:同一个最优控制问题,既可以写成二次规划,也可以利用时间结构通过 Riccati 递推求解。
**先修知识:**离散状态空间模型、二次型、矩阵求导与等式约束优化。
阅读路线:
- 先明确代价、动力学约束和初始状态,比较 QP 与 Riccati 两种求解思路。
- 再区分有限时域、无限时域和平衡点附近的局部控制。
- 最后阅读非线性系统案例及 TVLQR 轨迹跟踪,观察线性化的适用范围。
笔记结合 CMU 16-745 的课程与作业整理,相关材料见课程作业页面。文中的代码片段保留学习时的实现,运行时还需使用对应作业的依赖与上下文。
其他学习视角可参考向阳的笔记和知乎我爱科研 的整理
LQR:二次规划与 Riccati 递推#
按2025 年课程目录,LQR in 3 Ways 对应 Lecture 8;此前的笔记记为 Lecture 9,此处按主题组织。
线性二次型最优控制问题
x1:N,u1:N−1mins.t.k=1∑N−1(21xkTQxk+21ukTRuk)+21xNTQNxNxk+1=Akxk+Bkuk,x1=xinit其中,Q⪰0,R≻0。
- 根据A,B,Q,R是否随时间变化可以分为时不变和时变LQR,时不变 LQR 常用于平衡点附近的稳定控制,TVLQR 用于轨迹跟踪
- 可以在线性化点附近设计非线性系统的局部控制器;一次线性化得到的 LQR 解不等于原非线性最优控制问题的全局解。
将LQR转换为一个标准的QP问题求解#
定义优化变量z
z=u1x2u2..xNJ=21zTHz
H=R1000Q20..........00QNCz=d
C=B100(−I)A0...B.......(−I)AN−1......BN−100(−I)d=−A1x10.0这样就形式上转换成了一个标准的QP问题
zmin21zTHzs.t.Cz=d通过引入拉格朗日乘子给出拉格朗日函数,得到 KKT 线性方程组,可直接求解该等式约束二次规划;数值实现时还需检查相应矩阵的可解性
[HCCT0][zλ]=[0d]Riccati 方程求解(利用KKT中的稀疏性)#
下面先用 N=4、时不变 A,B,Q,R 的示意例子推导,终端权重为 QN。时变情形需要给各步矩阵加上下标。
R.BQ.−IAR.BQ.−IAR.BQN.−I..........BT−I.000ATBT−I.000ATBT−I.000u1x2u2x3u3x4λ2λ3λ4=000000−Ax100从末态x4开始
QNx4−λ4=0⟹λ4=QNx4考虑u3(分别代入λ4=QNx4和x4=Ax3+Bu3)
Ru3+BTλ4=Ru3+BTQNx4=Ru3+BTQN(Ax3+Bu3)=0⟹u3=−(R+BTQNB)−1BTQNAx3记成u3=−K3x3
到x3
⟹⟹⟹⟹Qx3−λ3+ATλ4=0Qx3−λ3+ATQNx4=0Qx3−λ3+ATQN(Ax3+Bu3)=0Qx3−λ3+ATQN(A−BK3)x3=0λ3=[Q+ATQN(A−BK3)]x3记为λ3=P3x3
这样依次递推出Kn和Pn,便可求出控制序列u1:N−1
PNKnPn=QN=(R+BTPn+1B)−1BTPn+1A=Q+ATPn+1(A−BKn)数值实现应求解线性方程组来计算增益,避免显式计算逆矩阵。时变形式为 Kn=(Rn+Bn⊤Pn+1Bn)−1Bn⊤Pn+1An、Pn=Qn+An⊤Pn+1(An−BnKn)。
例子-HW2 Q1#
Part A 离散化动力学模型#
考虑一个二阶积分系统,状态和控制变量如下
xu=[p1,p2,v1,v2]=[a1,a2]状态空间方程x˙=Ax+Bu
x˙=0000000010000100x+00100001u离散状态空间方程xk+1=Adxk+Bduk
在输入零阶保持、A2=0 时,Ad=I+AΔt、Bd=(IΔt+AΔt2/2)B。原式遗漏右乘 B,会使输入矩阵的维度错误。对本例:
Ad=[I20ΔtI2I2],Bd=[21Δt2I2ΔtI2].Part B: Finite Horizon LQR via Convex Optimization#
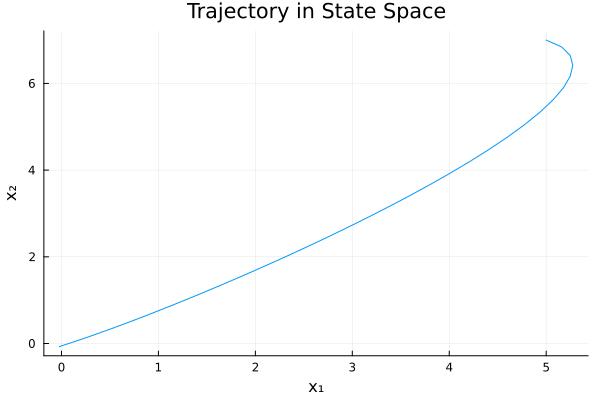
定义性能指标和约束方程,使用 Convex.jl求解得到 Xcvx,Ucvx = convex_trajopt(A,B,Q,R,Qf,N,x_ic)
x1:N,u1:N−1minsti=1∑N−1[21xiTQxi+21uiTRui]+21xNTQfxNx1=xICxi+1=Axi+Buifor i=1,2,…,N−1初态xic=[5,7,2,−1.4]
**验证 Bellman 最优性原理:**从原最优轨迹在时刻 L 的状态 xL∗ 出发,保留剩余时域、代价和约束,原最优控制序列的后缀仍是这个子问题的最优解。这不表示系统在任意中间时刻都已到达平衡点;若解不唯一,也不能要求重新求解后的轨迹必然逐点相同。
xL:N,uL:N−1minst i=L∑N−1[21xiTQxi+21uiTRui]+21xNTQfxNxL=xL∗xi+1=Axi+Buifor i=L,L+1,…,N−1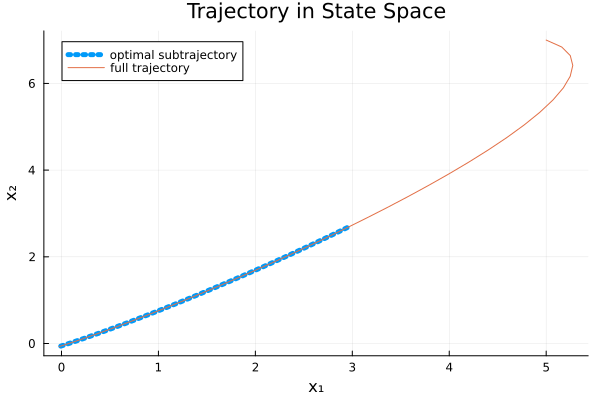
Part C:Finite-Horizon LQR via Riccati#
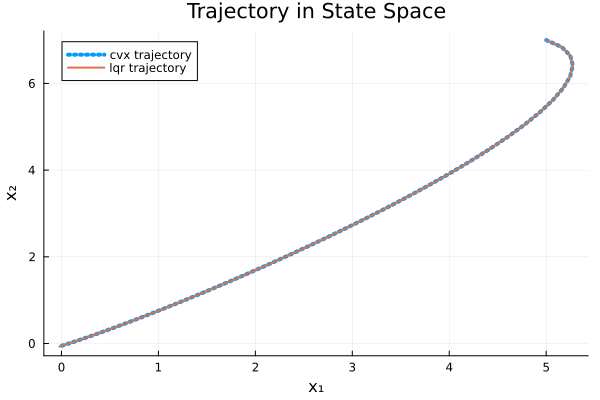
使用Riccati 方程递推求解离散LQR问题的解析解并与convex.jl的求解结果进行对比,结果是一致的
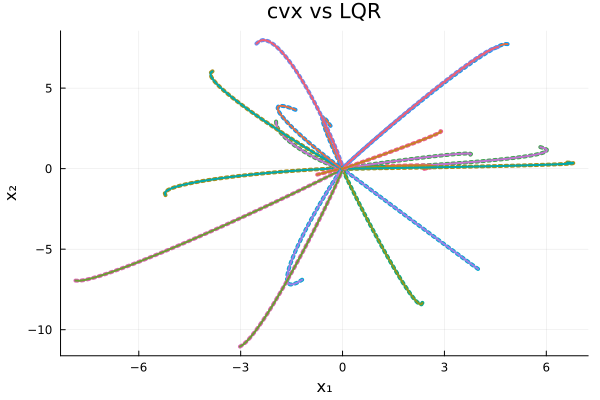
多次随机初始状态结果也是一致的
Part D: Why LQR is so great LQR的优异性#
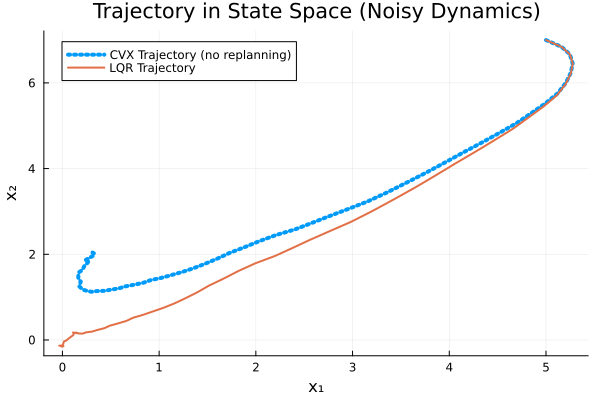
求出控制序列后,给实际的动力学系统加入噪声
xk+1=Axk+Buk+noisenoise = [.005*randn(2);.1*randn(2)]
此处比较的是一次求解后直接执行的开环控制序列,与每步根据实际状态计算的反馈控制 uk=−Kkxk。抗扰效果来自反馈;对于同一个无约束 LQR 问题,QP 与 Riccati 是等价的求解方法,不能据此认定 Riccati 求解器本身更鲁棒。QP 若每步重新求解,也能形成反馈。
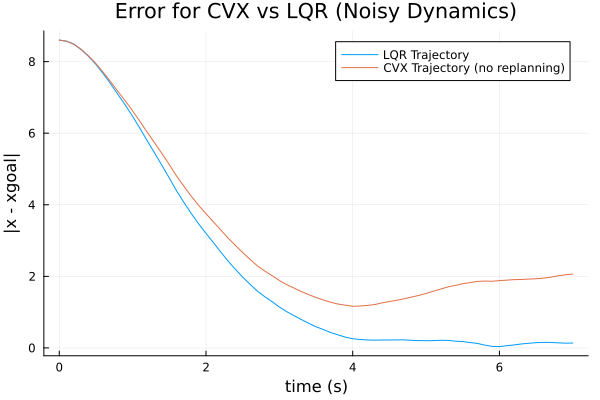
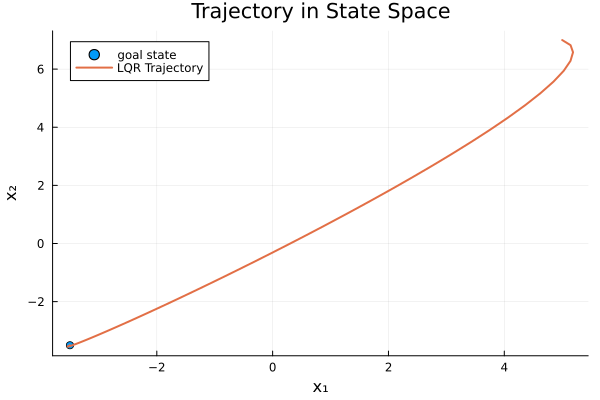
设定非零目标 xgoal=[−3.5,−3.5,0,0]。对本例双积分系统,它在零输入下仍是平衡点,因此可在误差坐标中使用 u=−K(x−xgoal)。一般系统需要先求满足平衡条件的 (xgoal,ugoal),再使用 u=ugoal−K(x−xgoal)。
Part E: Infinite -horizon LQR 无限时间二次型调节问题#
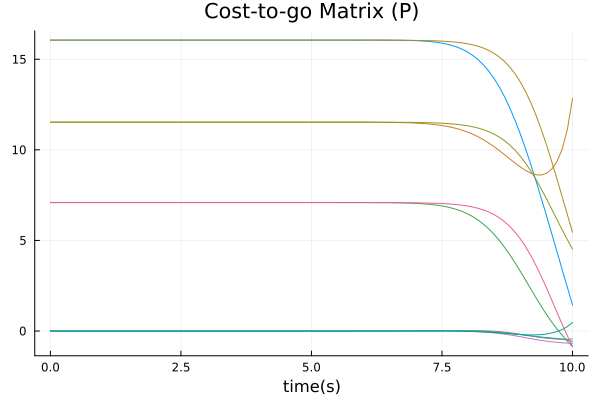
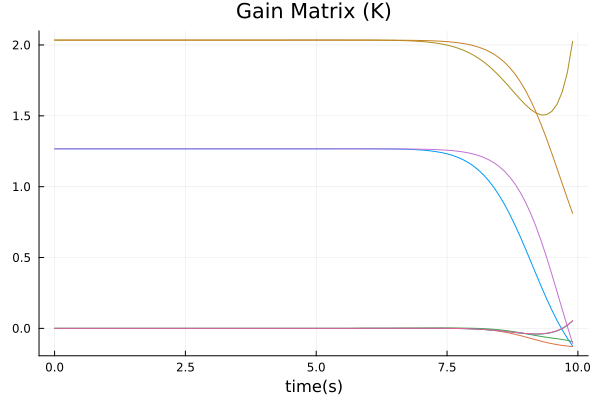
矩阵PK各元素的变化如图所示,可以看出对于一个有限时间的LQR系统,矩阵P(nx×nx)和K(nu×nx)在Ricatti反向迭代的过程中,经过一段时间就很快收敛。
对于时不变无限时域 LQR,在 (A,B) 可稳定、(Q1/2,A) 可检测且 R≻0 等标准条件下,可得到稳定化 Riccati 解和常数增益 K。有限时域曲线在本例中趋于平稳,不表示任意系统都能快速收敛。
例子-HW Q2 LQR for nonlinear systems#
Part 0 预备知识#
非线性系统线性化
给定参考状态轨迹xˉ1:N和参考控制轨迹uˉ1:N−1,定义增量坐标
xk=xˉk+Δxk,uk=uˉk+Δuk.对离散非线性动力学系统xk+1=f(xk,uk)进行线性化(一阶泰勒展开)
xk+1≈f(xˉk,uˉk)+Ak∂x∂f∣xˉk,uˉkΔxk+Bk∂u∂f∣xˉk,uˉkΔuk其中,Ak是状态雅可比矩阵(nx×nx),Bk是控制雅可比矩阵(nx×nu)
如果参考轨迹是动态可行的(即满足xˉk+1=f(xˉk,uˉk)),则泰勒展开式可简化为
xˉk+1+Δxk+1≈f(xˉk,uˉk)+AkΔxk+BkΔuk得到增量动力学方程
Δxk+1≈AkΔxk+BkΔuk线性时不变系统离散化方法
x˙(t)=Ax(t)+Bu(t)连续系统的解为
x(t)=eA(t−t0)x(t0)+∫t0teA(t−τ)Bu(τ)dτ使用零阶保持器(ZOH)控制u(t)=uk在t∈[tk,tk+1],则
xk+1=eAΔtxk+(∫0ΔteAτdτ)Buk构造增广系统
dtd[x(t)u(t)]=[A0B0][x(t)u(t)]在ZOH假设下u˙(t)=0,计算该系统的状态转移矩阵
exp([A0B0]Δt)=[eAΔt0∫0ΔteAτdτBI]通过计算增广矩阵的指数
exp([A0B0]Δt)=[Ak0BkI]
- Ak为左上n×n块
- Bk为右上n×m块
Part A: Infinite Horizon LQR about an equilibrium#
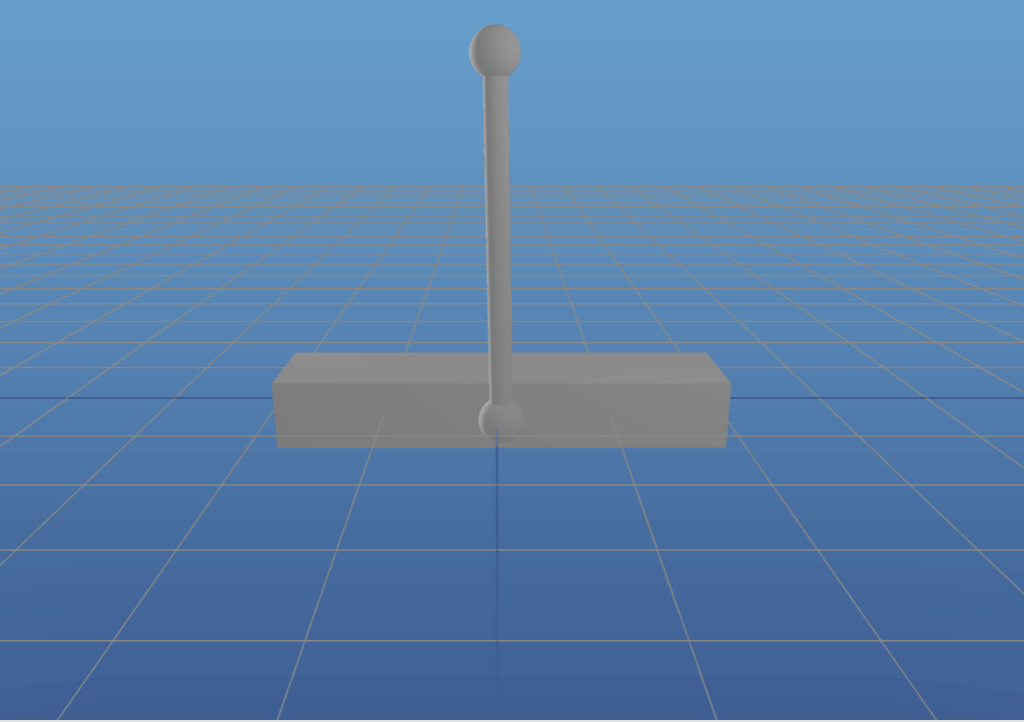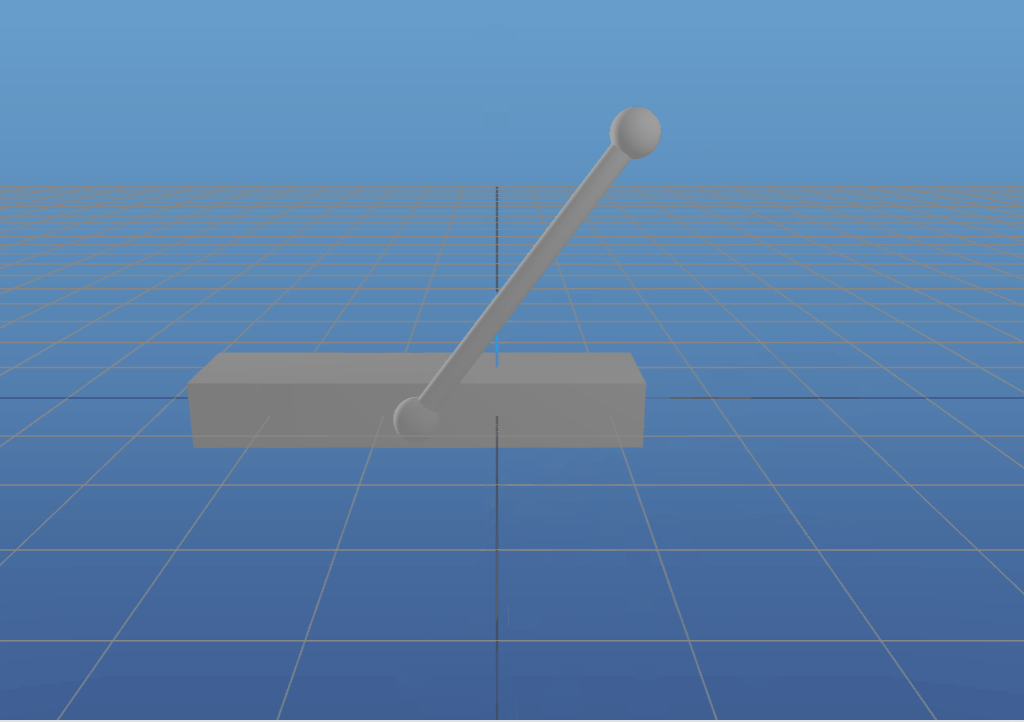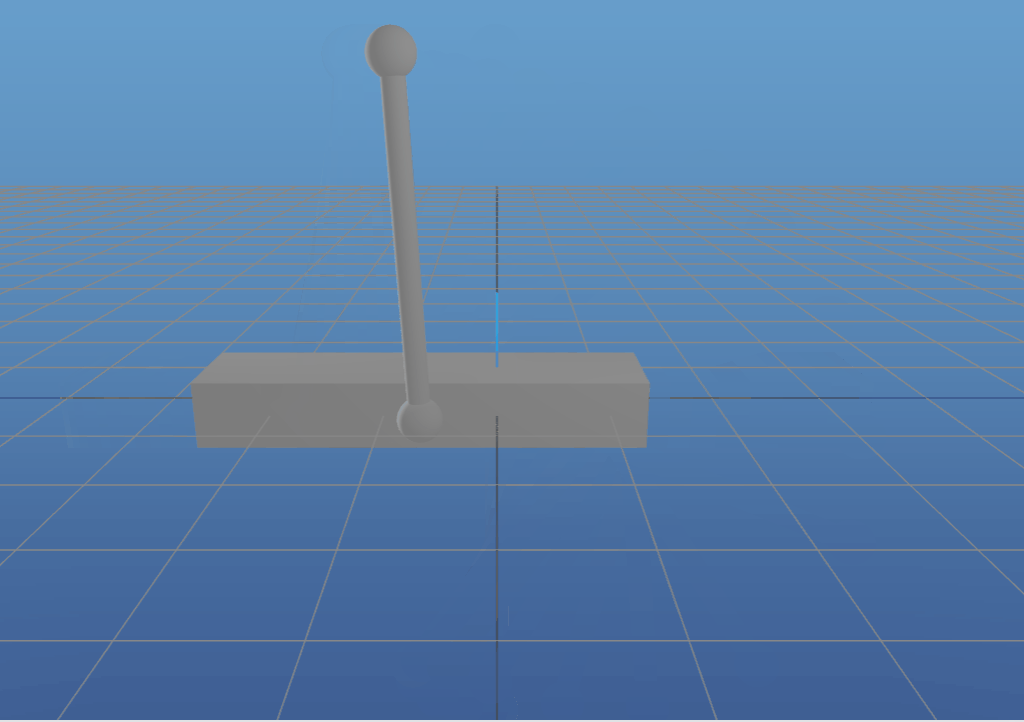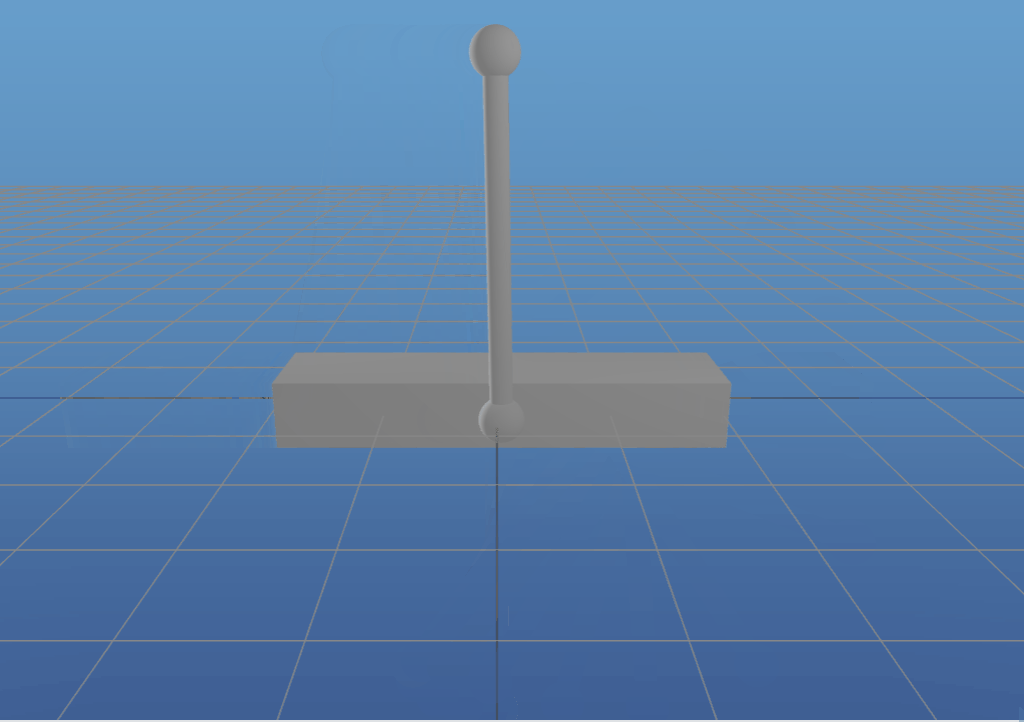
小车倒立摆(CartPole)的动力学方程
H(q)q¨+C(q,q˙)q˙+G(q)=Bu
- 广义坐标q=[p,θ]
- 质量惯性矩阵H=[mc+mpmplcosθmplcosθmpl2]
- 科里奥利矩阵C=[00−mplθ˙sinθ0]
- 重力向量G=[0mpglsinθ](此处 θ=0 为摆向下)
- 输入映射矩阵B=[10]
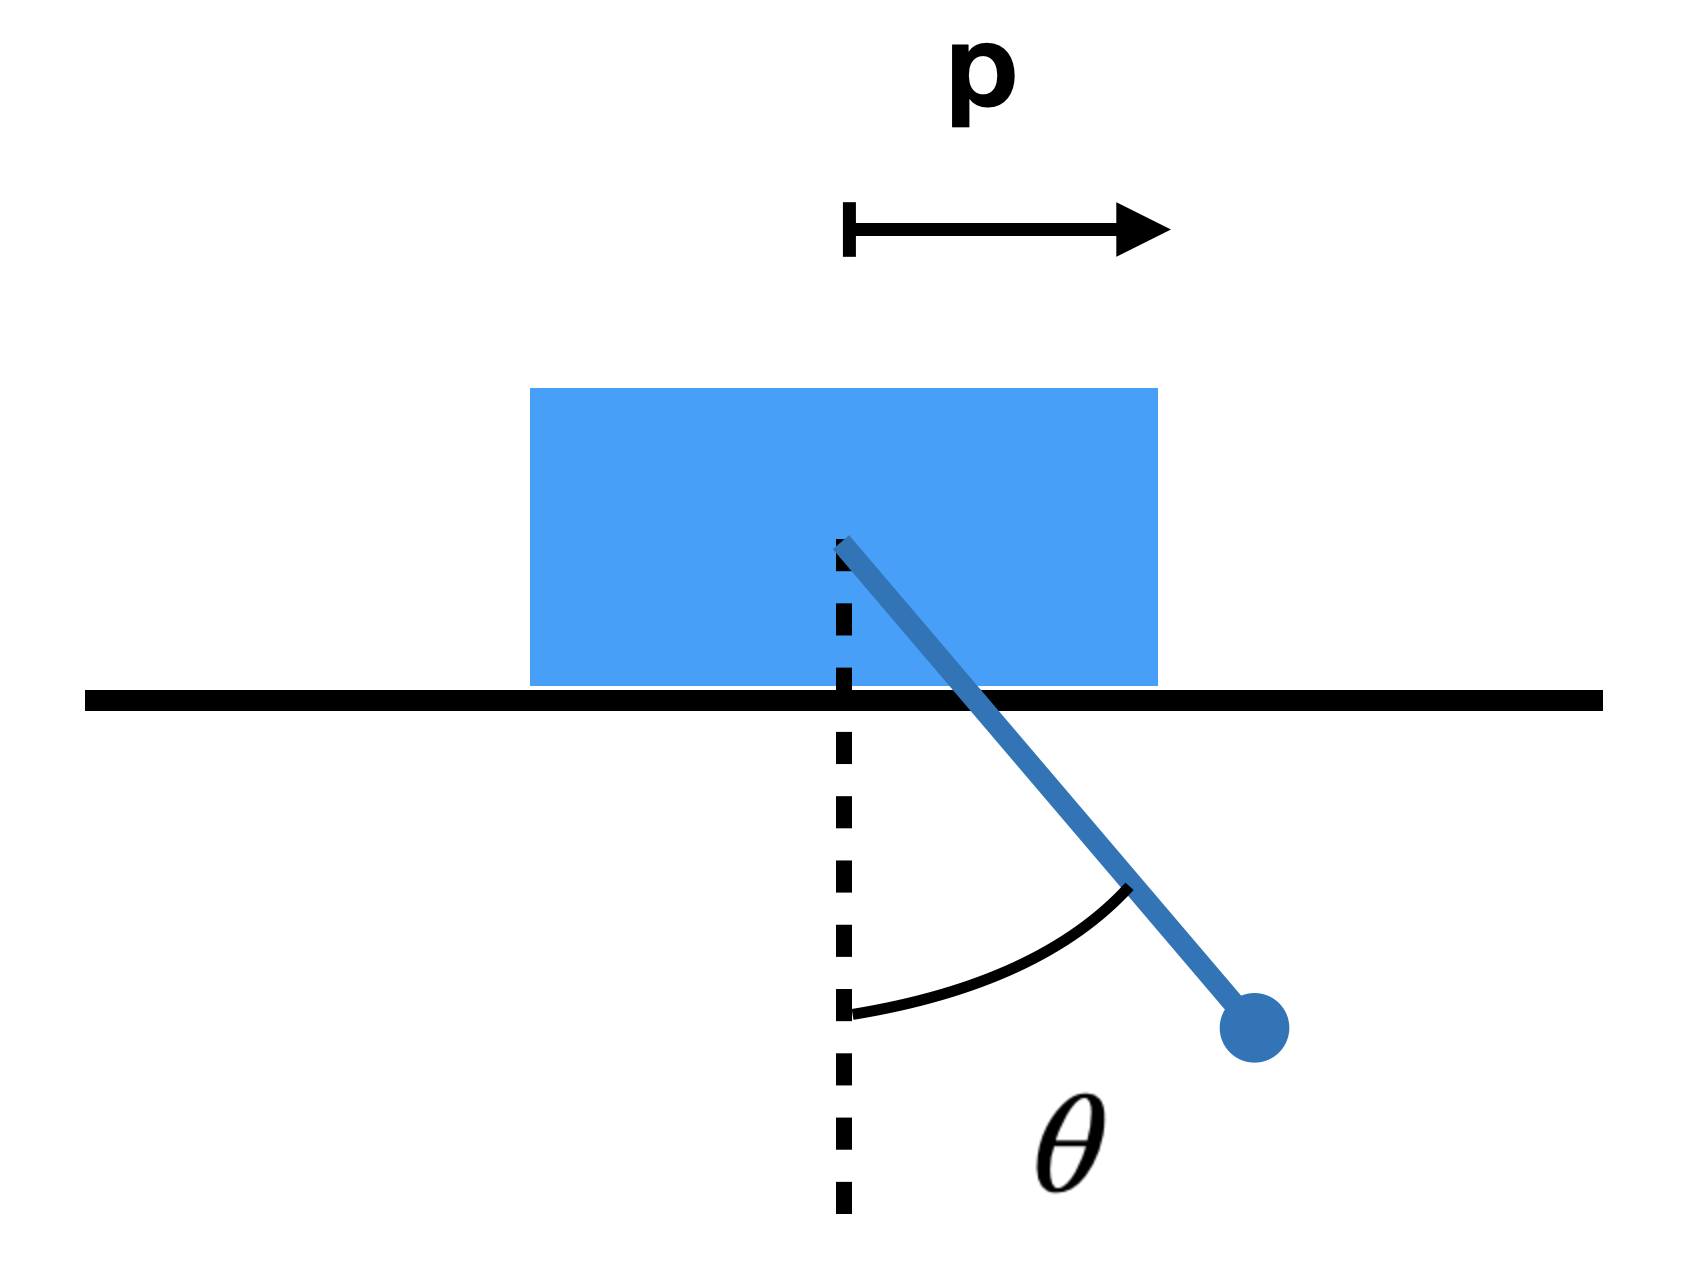
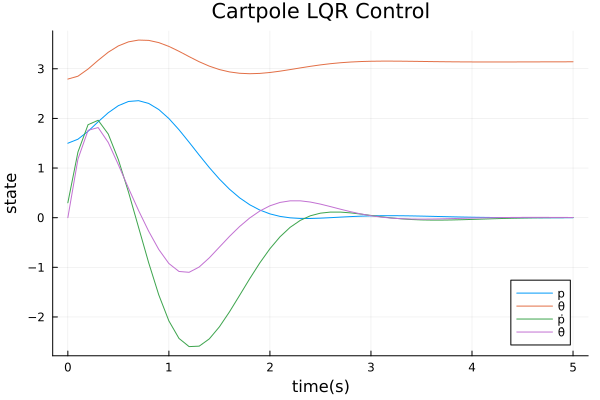
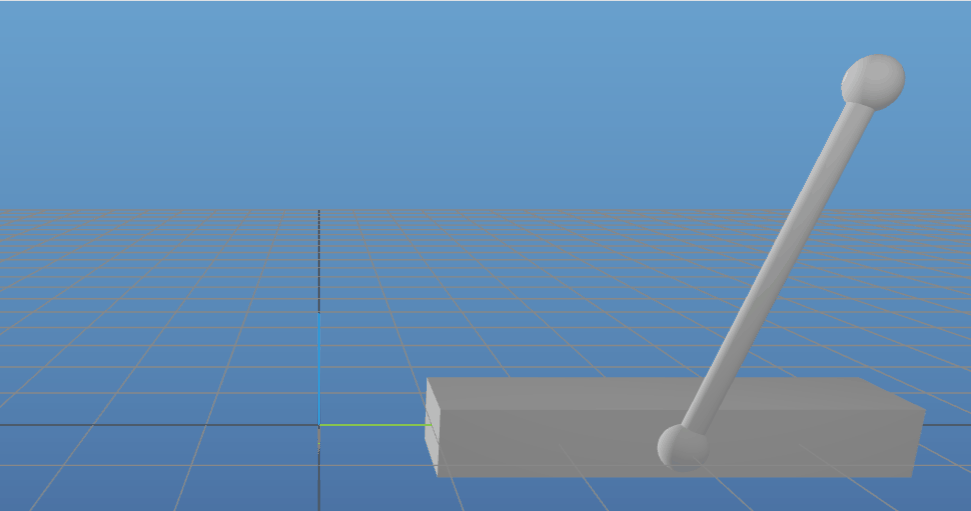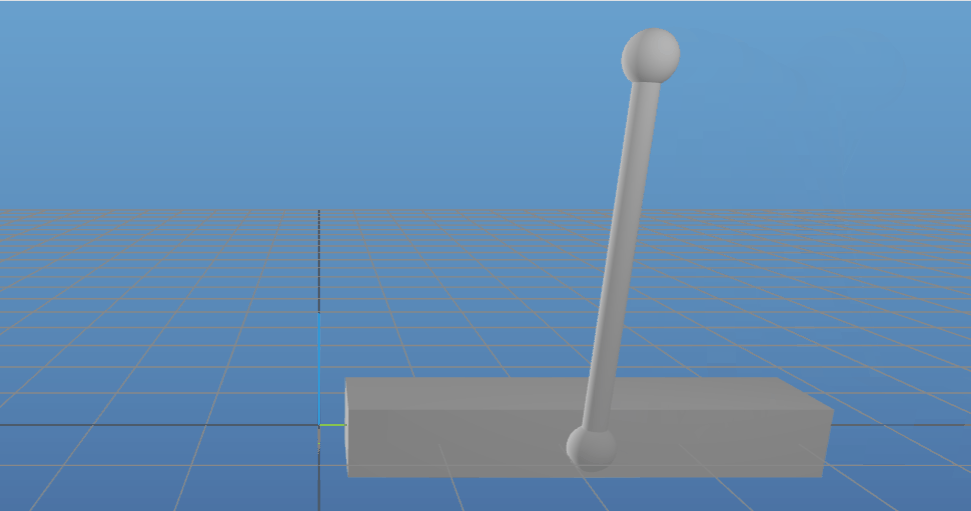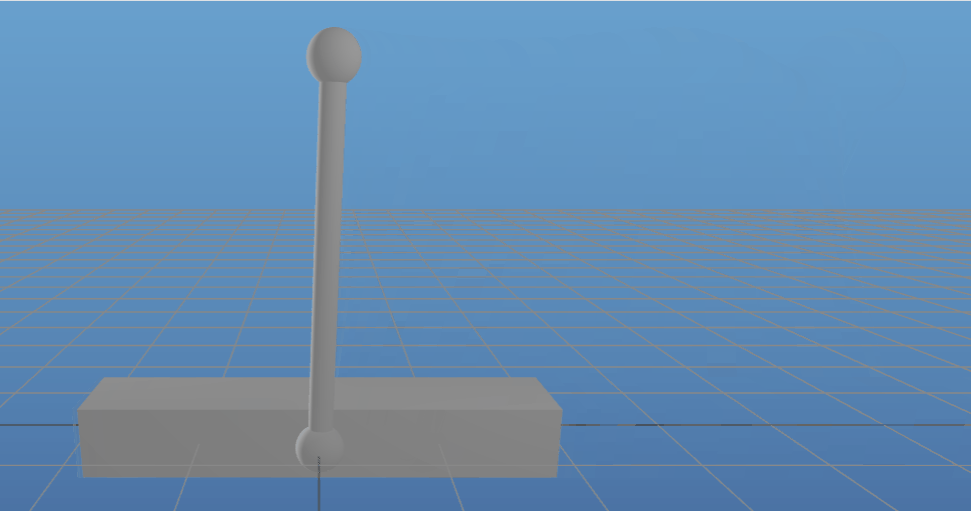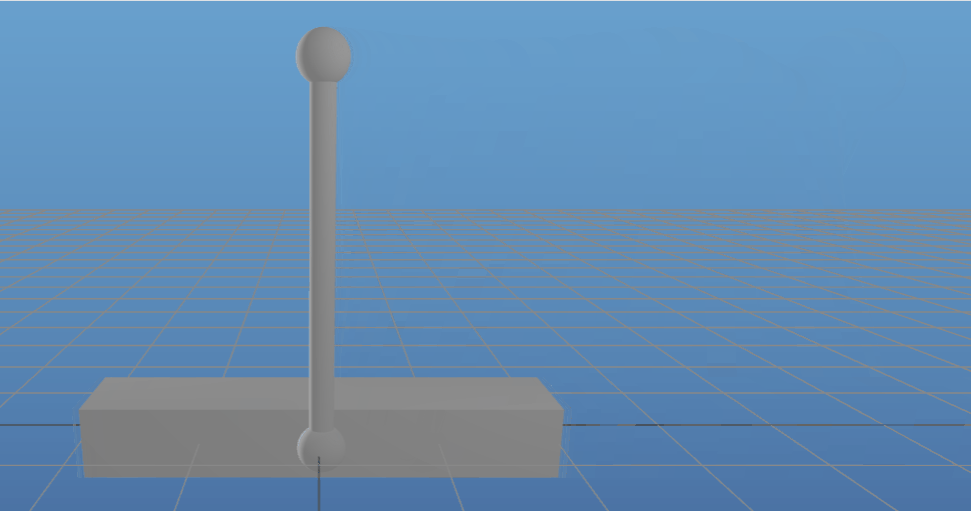
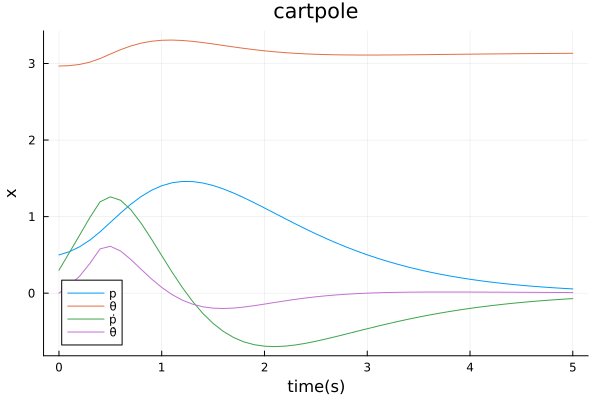
使用Infinite Horizon LQR将倒立摆小车稳定到平衡位置
x0 = [0, pi, 0, 0] + [1.5, deg2rad(-20), .3, 0]
Part B : Basin of Attraction吸引域分析#
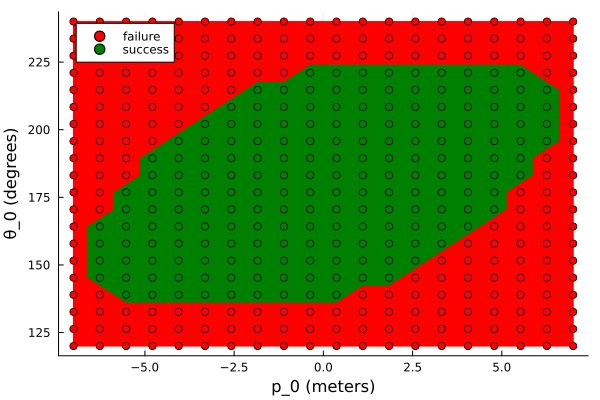
LQR控制器是基于系统在(xgoal,ugoal)处的线性近似设计的,当系统状态远离线性化点时,真实非线性动力学与线性模型差异变大,导致控制器性能下降甚至失效。
这里测试LQR控制器在不同初始条件下的稳定性,绘制吸引域,即能成功稳定的初始状态范围。
# create a span of initial configurations
thetas = LinRange(deg2rad(180-60), deg2rad(180+60), M)
Part C : 无限时域LQR调参#
本例通过调整 Q,R 并对输入限幅,检查给定初态下 5 秒末的误差是否小于 0.1。LQR 本身不显式处理 −3≤u≤3;截断控制会改变闭环系统,某次仿真满足条件不能保证其他初态也满足。需要硬约束时,应采用相应的约束优化控制方法。
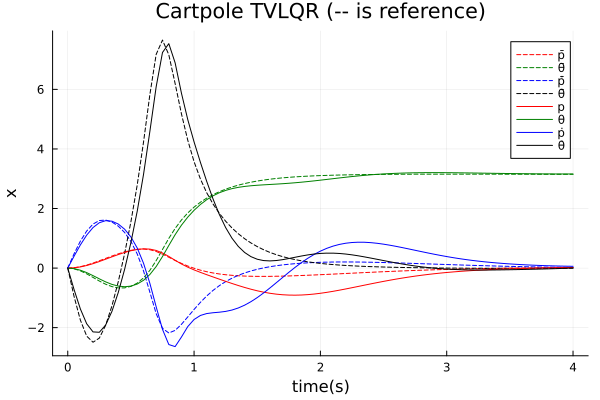
Part D: TVLQR for trajectory tracking#
在参考轨迹的每个点上线性化系统,设计时变反馈增益K(t),使系统能稳定跟踪时变目标。
function TVlqr(A_list::Vector{Matrix{Float64}}, B_list::Vector{Matrix{Float64}}, Q::Matrix, R::Matrix,
Qf::Matrix,N::Int64)::Tuple{Vector{Matrix{Float64}}, Vector{Matrix{Float64}}}
P = [zeros(nx,nx) for i = 1:N]
K = [zeros(nu,nx) for i = 1:N-1]
A,B = A_list[i],B_list[i]
K[i] = (R + B'*P[i+1]*B) \ (B'*P[i+1]*A)
P[i] = Q + A'*P[i+1]*(A - B*K[i])
整理与核查说明#
本笔记原有许可为 CC BY 4.0。引用的课程材料、代码和图片仍须遵守其各自的许可。
核查状态:部分验证(2026-10-04)。 已核对离散化、LQR 与二次规划关系及维度;完整摆杆实验未重新运行。
2026-10-04 整理时修正了已定位的公式和实现问题。文中的图片、动画和输出保留自学习时的实验记录,不代表修订后的代码已经完整重跑。作业片段依赖原项目环境,不能直接作为完整可运行教程;具体核查范围与尚未复现事项见正文。